
医学影像是疾病诊断、临床研究与医学人工智能发展的重要基础。然而,高质量医学影像数据的采集、标注与整理往往需要投入大量时间和专业资源,限制了医学数据的规模化利用。近年来,生成式人工智能为这一问题提供了新的解决思路,通过学习医学数据的内在分布生成高保真合成数据,为数据扩充和隐私保护提供了新的可能。其中,临床报告驱动的文本到图像生成能够将报告中的疾病描述转化为具有相应病理特征的医学影像,为连接临床语言与视觉疾病表征、拓展医学影像数据资源提供了新的技术途径。
然而,要实现高质量、疾病语义一致的医学影像生成,仍面临多重挑战。首先,真实医学数据中的噪声与异质性可能干扰模型对影像分布的学习,导致模型过度拟合非真实关联,影响生成结果的可靠性与泛化能力。其次,临床报告通常包含冗长的描述和复杂的医学术语,如何在压缩冗余信息的同时保留关键病理细节,并降低文本表征的计算开销,仍是重要问题。此外,如何从复杂的临床描述中有效提取疾病特异性信息,并将其准确融入影像生成过程,也直接影响生成结果与临床描述的一致性。因此,提升临床报告驱动医学影像生成的质量与效率,需要从训练数据质量、临床文本语义表征和疾病知识引导三个层面进行协同优化。
核心发现
近日,复旦大学生物医学工程与技术创新学院汪源源、郭翌团队提出了一种知识增强的医学影像生成框架UniMedDiff,通过协同优化训练数据质量、临床文本语义表征与疾病知识引导生成,提升了临床报告驱动医学影像生成的质量、效率与疾病语义一致性,为医学影像数据扩充及医学人工智能下游任务提供了新的技术方案。相关成果以《UniMedDiff: A Knowledge-Enhanced Diffusion Model for Medical Image Generation from Clinical Reports》为题,发表于 npj Digital Medicine 期刊。
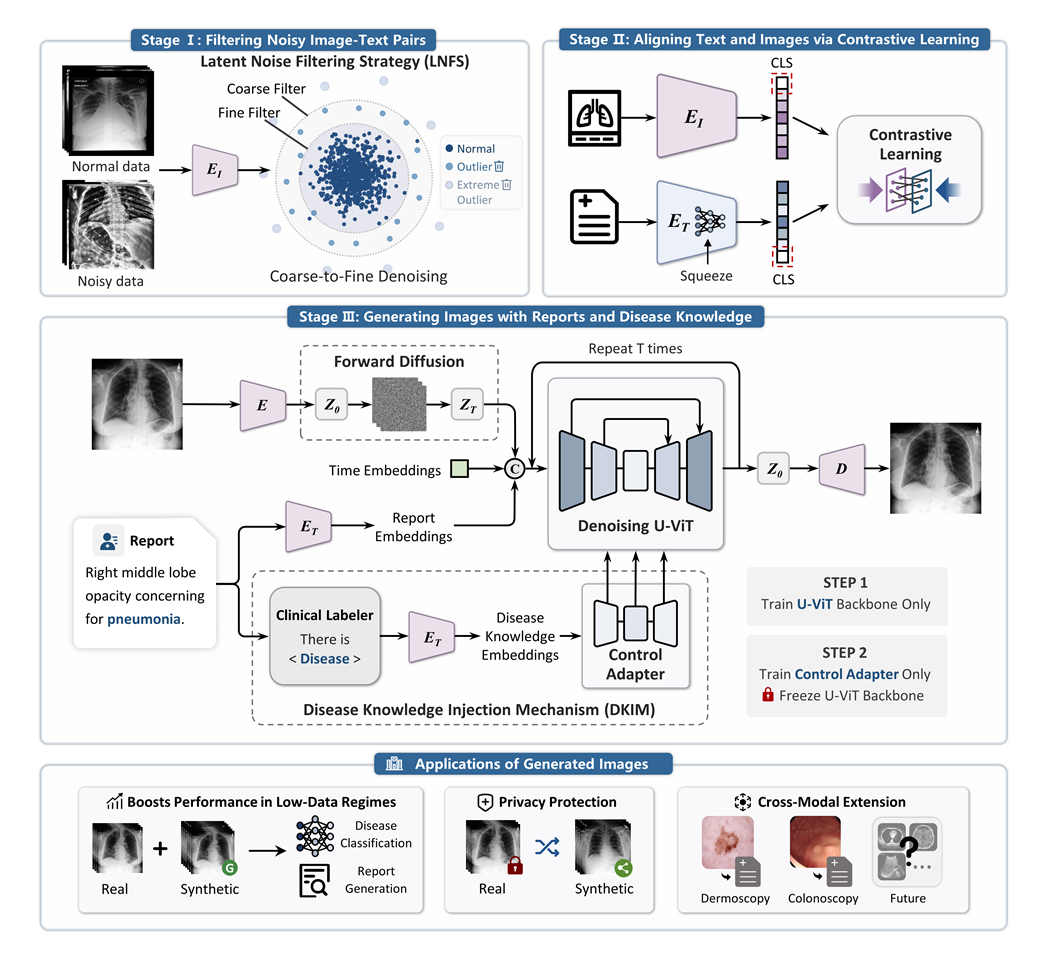
针对临床报告与医学影像之间的语义—视觉差异,研究团队设计了三个相互协同的关键模块。首先,潜在空间噪声过滤策略(Latent Noise Filtering Strategy,LNFS)识别并过滤训练数据中的异常潜在表征,降低噪声图像—文本配对对模型学习的干扰;其次,自适应视觉感知文本学习策略(Adaptive Vision-Aware Textual Learning Strategy,AVA-TLS)对冗长临床报告中的语义信息进行压缩与提炼,形成更紧凑、与医学影像视觉特征相关的文本表征,提高临床语义利用效率;最后,疾病知识注入机制(Disease Knowledge Injection Mechanism,DKIM)将结构化疾病先验融入扩散模型的去噪过程,为影像生成提供疾病相关约束,促进生成结果准确呈现临床描述中的病理特征。三个模块分别从数据质量、文本语义和疾病知识引导三个层面协同作用,旨在减少数据噪声、报告冗余及语义—视觉不匹配对医学影像生成的影响。
在医学影像生成质量与多样性方面,UniMedDiff 展现出良好的综合性能。在公开胸部 X 线影像数据集MIMIC-CXR上,生成图像的FID为19.500,优于所比较的现有方法;在分布外数据集 IU-Xray 上,FID达到31.459,体现出良好的跨数据集泛化能力。在生成多样性方面,模型在 MIMIC-CXR 和 IU-Xray 上的MS-SSIM分别为0.377和0.351,体现出良好的样本多样性。在计算效率方面,UniMedDiff 的计算复杂度仅为代表性扩散模型RoentGen的约三分之一,推理速度较对比扩散模型和自回归模型分别提升约4 倍和7.6 倍。在疾病表征方面,模型在MIMIC-CXR和IU-Xray上的mAUC分别达到0.678 和 0.763。进一步的放射科医师盲法评估显示,生成影像与对应疾病标签及临床报告具有较好的一致性;影像到报告生成、图像检索及病灶特征一致性分析也从不同角度验证了生成影像对疾病相关信息与病理特征的保留能力。
除生成影像本身的质量与医学语义表现外,研究团队进一步验证了UniMedDiff 在下游医学人工智能任务中的应用价值。在胸部X线影像分类任务中,研究团队评估了合成影像对不同数据规模及模型架构的增强效果。实验结果显示,在仅使用 1% 真实训练数据的条件下,合成数据增强使不同数据集与模型架构组合下的mAUC 提升0.047–0.225,其中ChestX-ray14 数据集上的MaxViT模型相对性能提升达到40.8%。此外,合成胸部X线影像还可用于自监督表征学习,合成影像—报告配对也可用于放射学报告生成,进一步改善下游任务表现。研究团队还将UniMedDiff拓展至皮肤镜和结肠镜影像生成。在仅使用1%真实训练数据的条件下,加入合成影像进行数据增强后,皮肤镜分类任务的mAUC 和F1 分别提升0.223 和0.454,结肠镜分类任务则分别提升0.052 和0.212。这些结果表明,UniMedDiff 生成的合成影像不仅能够补充胸部X线影像数据,还可为不同医学影像类型的下游任务提供数据支持,在低资源医学人工智能场景中展现出应用潜力。
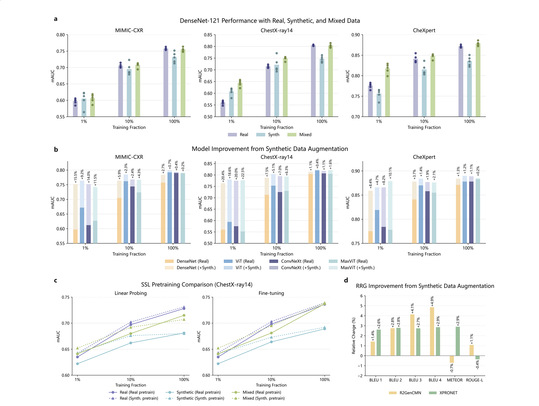
总体而言,该研究提出了一种融合训练数据质量控制、临床文本语义表征与疾病知识引导的医学影像生成框架UniMedDiff,在生成质量、计算效率和疾病语义一致性等方面进行了系统验证,并进一步探索了合成影像在下游任务和不同医学影像类型中的应用价值。该研究为构建高质量医学合成数据、拓展生成式人工智能在医学影像分析中的应用,以及缓解医学人工智能领域的数据稀缺问题提供了新的思路。
论文信息
复旦大学生物医学工程与技术创新学院2024级博士生刘乐萱和2022级硕士生黄鹏共同担任本文的第一作者,郭翌、汪源源和周子夏共同担任通讯作者。本研究得到国家自然科学基金的资助。
论文链接
https://doi.org/10.1038/s41746-026-03135-x